요즘 Threads에 자주 글을 씁니다. Threads의 특성상 짧은 글을 자주 올리다 보니, 어떤 글에 반응이 있었는지 매번 들어가 확인하는 것도 일이 됐습니다. 며칠만 지나도 예전 글은 피드 아래로 밀려나고, Threads가 제공하는 기본 인사이트로는 자세한 반응을 한눈에 보기 어렵습니다.
그래서 Threads 반응 분석 도구를 바이브 코딩으로 직접 만들어 보기로 했습니다. 브라우저로 화면을 읽는 것에서 출발해 엑셀로 정리하고, AI가 분석까지 해주는 대시보드로 키웠습니다. 전체 작업은 1시간 안에 마무리했습니다. 이번 글에서는 이 경험을 정리하고, 이제는 필요한 앱을 직접 만들어 쓰는 시대가 되었다는 생각을 기록해 보았습니다.
참고로, 이번에는 OpenAI의 Codex를 사용했고, 이전에 다른 앱을 개발할 때보다 AI에게 많은 부분을 맡겼습니다. 로컬에서 저 혼자 사용할 앱이기 때문입니다. 그럼에도 사람이 끝까지 판단해야 했던 것은 무엇인지도 함께 정리해 보겠습니다.
Threads, 기록을 쌓기 어려운 SNS
Threads는 짧은 글을 자주 올리는 SNS입니다. 게시물 하나가 500자로 제한되어 있어서, 블로그처럼 공들여 쓰기보다 떠오르는 생각을 가볍게 올리게 됩니다. 제 계정을 API로 조회해 보니 약 6개월 동안 1,592개 항목이 쌓여 있었습니다. 최근 30일만 봐도 직접 쓴 글과 인용 글이 252개, 하루 평균 약 8개입니다.
문제는 이렇게 빠르게 쌓인 글을 다시 돌아보기가 어렵다는 점입니다. Threads도 기본 인사이트를 제공합니다. 게시물별 조회 수와 반응을 볼 수 있고, 최근에는 내 글을 정렬해 성과를 비교하는 기능도 생겼습니다. 다만 공식 안내에 따르면 조회 기간은 최대 90일입니다. 계정 데이터 다운로드를 요청할 수는 있지만 준비에 최대 30일이 걸리고, 반응 수치는 들어 있지 않은 것으로 알려져 있습니다.
기록을 모아서 함께 보는 기능도 부족합니다. 게시 관리 서비스 PostEverywhere는 기본 인사이트에서 원하는 두 기간을 비교할 수 없다고 설명합니다. 예전 글은 프로필 검색과 날짜 지정으로 찾을 수는 있지만 키워드를 넣어야 하는 방식이라, 반응이 좋았던 글만 모아 보기는 어렵습니다.
유료 분석 서비스도 있지만, 저는 단순한 서비스가 필요했습니다. 발행일별로 어떤 글에 반응이 있었는지, 댓글에서는 어떤 이야기가 오갔는지 보고, 그 내용을 편하게 받아 보고 싶었습니다. 그래서 AI를 통해 만들어 보았습니다.
1단계, 브라우저로 읽기
첫 요청은 아주 간단하게 전달했습니다. 최근 글의 조회 수, 좋아요, 댓글을 모아 알려주고, 댓글은 짧게 요약해 달라고 했습니다. 단, 읽고 정리만 하고, 게시물이나 댓글은 절대 올리면 안 된다고 제한을 두었습니다. 정리하는 과정에서 가져올 수 있는 정보와 가져올 수 없는 정보도 구분해 달라고 했습니다.
그러자, Codex는 내장 브라우저로 Threads 사이트에 접속해서 데이터를 직접 읽는 방식을 선택했습니다. 제 프로필을 열고 공개 화면에서 최근 글 5개를 읽었습니다. 좋아요와 댓글 수는 물론 댓글 내용까지 가져왔고, 처음에는 확인이 어렵다고 했던 조회 수도 게시물 상세 화면에서 찾아냈습니다. 제가 인용한 다른 사람 글의 반응 수를 따로 빼는 것도 알아서 처리했습니다.
하지만 제가 원하는 방식이 아니었습니다. 화면을 하나씩 열어야 하니 비효율적이고, 예전 글까지 한꺼번에 확인하기도 어려웠습니다.
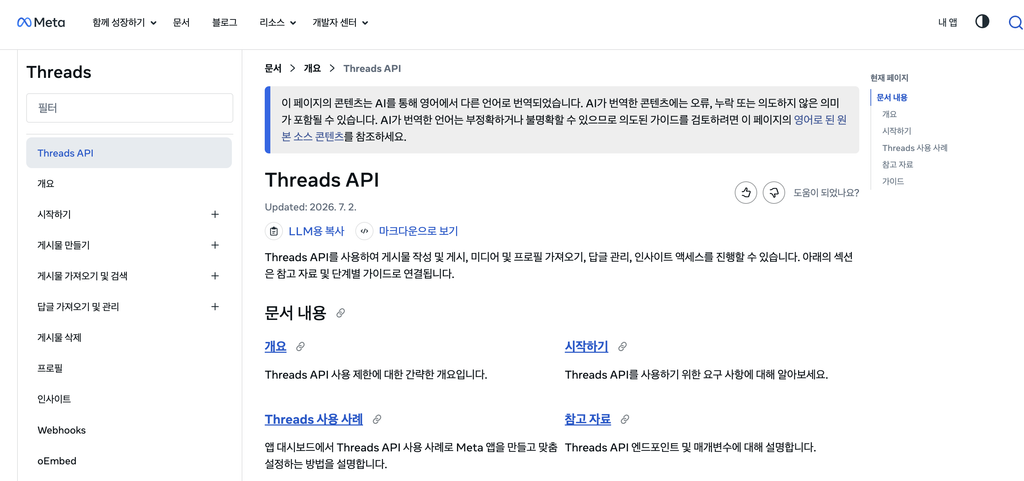
제가 방향을 직접 주고 싶지 않아서, “매번 화면을 열어서 봐야 해?”라고 물었더니, 그제야 Codex는 Threads 공식 API로 게시물 목록과 반응 통계, 댓글을 가져오는 방법을 제안했습니다. 이 질문이 핵심이었고, 이를 통해 방향이 바뀌었습니다.
2단계, API 연결 후 엑셀 저장
API 연결은 보통 귀찮고 번거로운 과정입니다. Meta 개발자 계정을 만들고, 앱을 생성하고, 권한을 설정해야 합니다.
그런데 이번에는 의도적으로 AI에게 맡겼고, 제가 직접 한 일은 거의 없었습니다. Codex는 브라우저 창을 띄워 진행 과정을 그대로 보여주었고, 언제든지 제가 중지할 수 있었습니다. 그래서 저는 이를 지켜보면서 편하게 따라갔습니다. 권한은 통계 읽기와 댓글 읽기만 추가하고, 게시/삭제/댓글 관리 권한은 넣지 않았습니다. Codex는 로그인, 약관 동의, 권한 부여처럼 계정에 영향을 주는 단계에서는 진행을 멈추고 제 확인을 받았습니다.
가장 중요한 토큰 발급 단계에서는 발급받은 토큰을 대화창에 붙여넣지 말고 PC의 특정 파일에 저장하라는 안내를 받았습니다.
API가 연결된 뒤에는 가장 익숙한 엑셀로 만들어 보기로 했습니다. 지난 일주일 데이터를 파일 하나에 모으는 것이 첫 목표였습니다.
시트는 두 개로 나눴습니다. 첫 번째 시트에는 원본 데이터를 담았습니다. 글, 댓글, 대댓글을 한 줄씩 쌓고 각각 원글과 연결했습니다. 두 번째 시트에는 날짜별 글 수와 반응 합계, 인기 글 TOP 5, 차트를 넣었습니다. 9월 22일부터 28일까지 제가 쓴 글 73개와 댓글·대댓글 858개, 모두 931행이 모였습니다. 표 색상이 어색해서 한 번 다듬기도 했습니다.
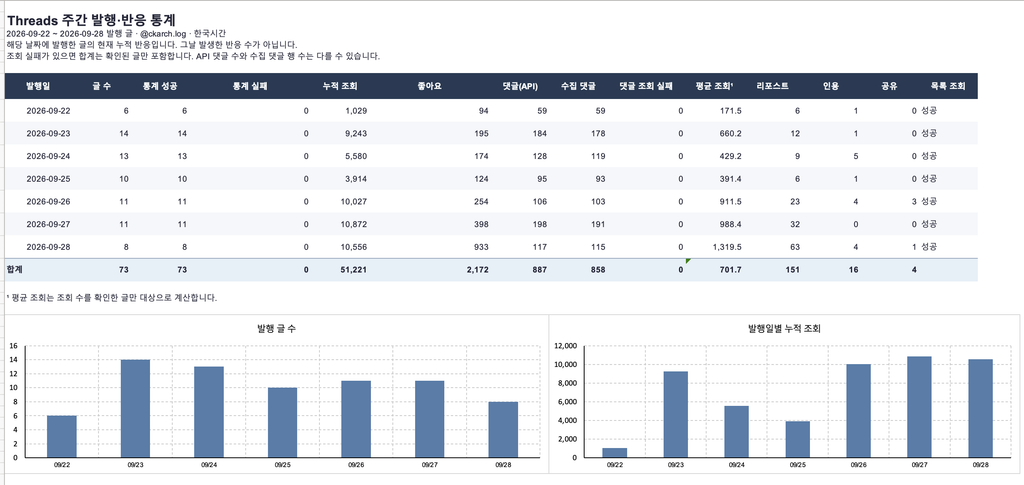
이런 통계를 구성할 때 헷갈리기 쉬운 게 숫자의 정의인데요. 우선 누적 반응과 하루 증감은 서로 다른 지표입니다. “9월 28일 조회 수”를 그날 하루 동안 쌓인 조회 수로 할지, 아니면 그날 올린 글이 지금까지 받은 조회 수일지 명확하게 정의해야 합니다. AI와 대화를 주고받으면서 이런 개념을 정리해 나가는 과정이 필요했습니다.
또 ‘실제 값이 0인 경우’와 ‘조회에 실패한 값’도 구분을 해야 합니다. 조회에 실패한 글을 0으로 채우면 합계와 순위가 틀어지기 때문에, 빈칸으로 두고 실패 이유를 적어 두었습니다. 댓글 개수도 차이가 있었는데, API가 알려준 댓글 수는 887개인데 실제로 가져온 댓글은 858개였습니다. 아마 삭제되거나 차단된 댓글까지 개수에 포함된 것으로 보입니다. 그래서 두 수치를 함께 표시했습니다.
API로 확인한 글 개수 1,592개에는 제가 쓴 글뿐만 아니라 리포스트와 인용 등이 포함되어 있습니다. 숫자를 사용할 때는 그 숫자가 무엇을 뜻하는지 정하는 일이 중요합니다.
3단계, 대시보드와 AI 분석
엑셀을 만들어 보며 원하는 데이터 추출이 가능하다는 것은 확인을 했습니다.
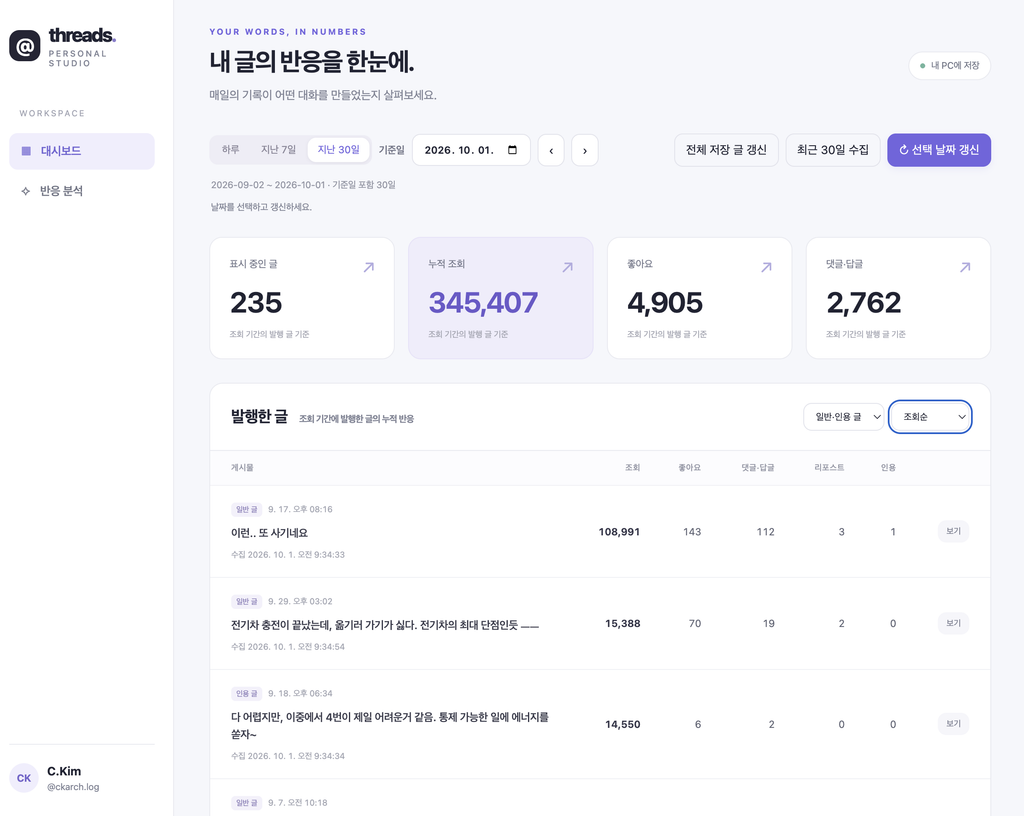
이번에는 대시보드를 만들기로 했습니다. 우선은 저 혼자 사용할 앱이기 때문에 별도의 호스팅은 하지 않고 로컬에서만 실행하도록 했습니다. 특정 날짜를 고르면 그날 올린 글과 반응이 나오고, 갱신할 때마다 기록을 남기는 것으로 구성했습니다.
최근 30일 일괄 수집, 일/주/월 단위 조회, 저장된 글 전체 갱신 기능 등 필요한 기능들은 구현하면서 차례로 추가했습니다. 화면이 길게 이어지는 게 불편해서 대시보드와 반응 분석을 별도 페이지로 나눴고, 반응 순위도 ‘수집 사이 변화’와 ‘누적 순위’ 탭으로 구분했습니다. 화면 디자인도 전체적으로 손봤습니다. 처음부터 설계를 하고 시작한 게 아니기 때문에 직접 눈으로 보기 전에는 예상하지 못했던 기능들을 생각나는 대로 추가해 나갔습니다.
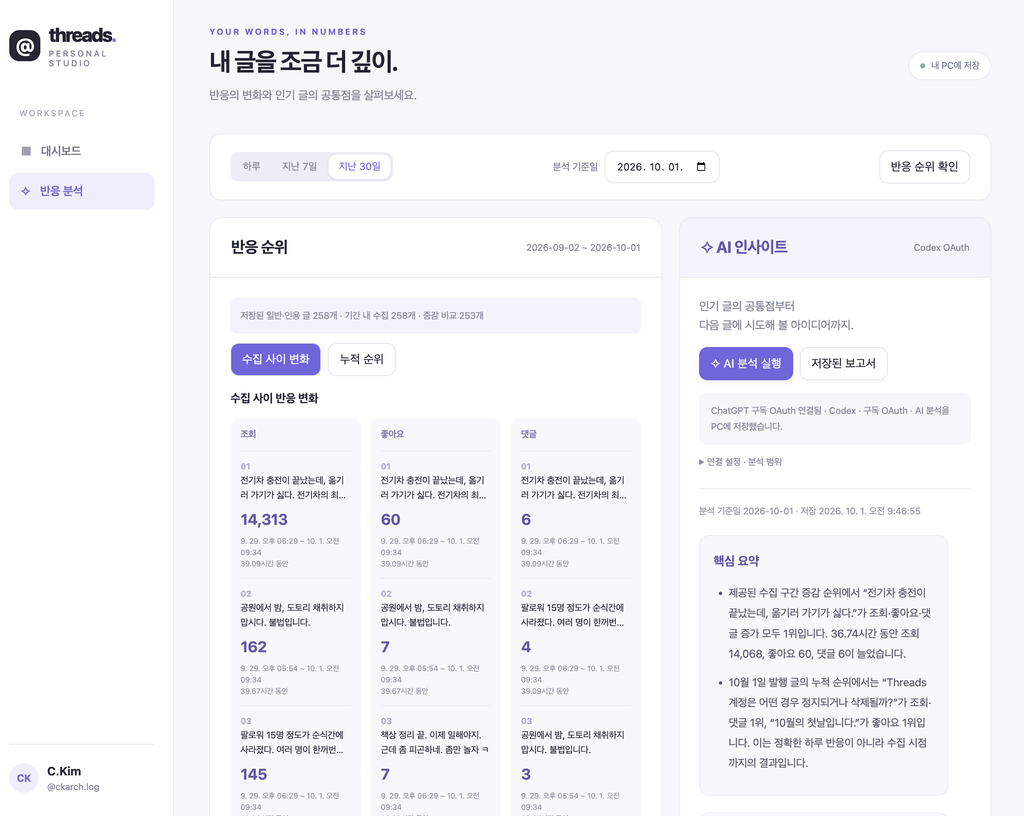
마지막으로 AI 분석을 붙였습니다. 인기 글의 본문과 통계를 바탕으로 그런 글들의 공통점과 반응이 좋았던 이유에 대한 가설을 세우고 다음에 시도해 볼 아이디어를 정리하게 했습니다. 확인된 사실과 추정을 구분하고, 확인할 수 없는 정보는 미루어 짐작하지 말라는 조건도 넣었습니다. AI 분석은 간단하게 추가해본 수준이라, 의미 있는 결과를 얻으려면 더 다듬어야 할 것 같습니다.
|
핵심 요약 |
|
|
주요 발견 |
|
|
해석 가설 |
|
|
다음 시도 |
|
|
해석 시 |
|
GPT를 연결하는 방법은 두 가지입니다. API 키 방식은 쓴 만큼 사용료를 내며, ChatGPT 구독과는 별도로 결제됩니다. 구독 계정 인증(OAuth) 방식은 이미 쓰고 있는 구독의 사용 한도 안에서 쓸 수 있습니다. 혼자서 가끔 돌리는 분석이라 추가 비용이 들지 않는 OAuth 방식을 택했습니다.
의도적 바이브 코딩
이번 작업에서는 의도적으로 코드를 거의 보지 않고, 말 그대로 ‘입 코딩’을 해봤습니다. 요구사항을 전달한 후 화면과 결과만 확인하고, 이상한 부분이 있으면 다시 말로 고쳐 달라고 했습니다. 중요한 서비스를 개발하는 상황이면 권하지 않을 방식입니다. 그런데도 이렇게 해 본 이유는 이 앱의 사용자가 저 한 사람이고 로컬 환경에서만 사용할 앱이기 때문입니다.
만약 사용 범위가 넓은 서비스였다면 상황이 달랐을 것입니다. 최근 사례를 하나 살펴보겠습니다. 2026년 9월 보안 업체 UpGuard의 발표에 따르면 Supabase를 쓰는 약 30만 개 도메인을 조사해, 16,326개 데이터베이스의 테이블을 외부에서 그대로 읽을 수 있었다고 합니다. Supabase는 바이브 코딩으로 만든 웹 앱에서 많이 쓰는 백엔드입니다. 조사 대상은 자체 도메인으로 운영되는 실제 서비스였고, 절반 이상에서 개인정보가 나왔습니다.
원인은 아주 단순했습니다. Supabase는 화면에서 만든 테이블에는 행 수준 보안(RLS)을 기본으로 켜지만, 코딩 에이전트처럼 API로 만든 테이블에는 자동으로 켜지 않습니다. 사람이 화면에서 만들었다면 켜졌을 보호 설정이 꺼진 채로 남아 있었던 것입니다. AI는 사용자의 요구사항을 들으면 그것을 아주 성실하게 구현합니다. 하지만 보안이나 권한 같은 것들은 따로 말하지 않으면 알아서 먼저 반영하지 않습니다. 동작하는 코드와 옳은 코드는 다릅니다.
그래서 AI에 무엇을 얼마나 맡길지는 앱의 사용 범위가 정한다고 생각합니다. 이번 앱은 제 PC에서만 실행할 예정이고, 제 계정만 읽고, 게시 권한도 없습니다. 문제가 생겨도 그 비용은 저에게만 돌아옵니다. 사용 범위가 좁을수록 AI에 맡길 수 있는 폭은 넓어지는 것 같습니다. 반대로 고객 데이터를 받기 시작하는 순간 물어야 할 질문이 달라집니다. 혼자 쓰던 앱을 지인에게 열고, 반응이 좋아 어느새 고객을 받게 되면 코드는 그대로인데 앱의 성격은 완전히 바뀝니다. 범위가 바뀌면 AI에게도 알리고, 보안처럼 새로 챙겨야 할 부분을 다시 점검해야 합니다.
그렇다고 모든 걸 맡긴 것은 아닙니다. 제가 끝까지 챙긴 일은 세 가지입니다. 첫째는 권한입니다. 읽기만 한다는 조건, 권한을 어디까지 줄지, 토큰을 어디에 둘지는 제가 정했습니다. 둘째는 숫자의 정의입니다. 누적과 증감을 구분하고, 실제 값이 0인 경우와 조회에 실패한 값도 구분했습니다. 그렇지 않았다면 그럴듯해 보이지만 틀린 대시보드가 나왔을 겁니다.
셋째는 방향 교정입니다. Codex는 시킨 일을 성실하게 해냈지만 틀릴 때도 있었습니다. 처음에는 API 결제가 꼭 필요한 것처럼 안내해서 구독 인증 방식을 제가 알려주었고, AI 분석이 완성됐다고 보고했지만 실제로는 통계만 나오고 있었습니다.
이런 부분을 알아챌 수 있었던 건 제가 관련 지식을 알고 있고, 대략적인 구조를 예측했기 때문일 것입니다.
맺음말
Threads 반응을 확인하기 위해, 브라우저로 읽기와 엑셀 정리를 거쳐, AI가 분석하는 대시보드까지 확장해 보았습니다. 다음에는 스케줄러를 붙여 매일 자동으로 수집하고 분석하게 만들어 보려고 합니다.
만드는 동안 예전 회사 생활이 떠올랐습니다. 그때는 필요한 기능을 엑셀로 만들어 쓰는 일이 많았습니다. 수식 몇 개와 매크로 하나로 반복 업무를 줄이는 식이었습니다. 거창한 프로그램은 아니었지만 일종의 상황 맞춤형 도구였습니다. 이번 작업을 하면서도 그때와 비슷한 느낌이 들었습니다. 달라진 점은 엑셀 시트 대신 앱이 만들어진다는 것 정도였습니다.
예전에는 필요한 기능이 있으면 그 기능을 가진 앱을 찾았습니다. 찾지 못하면 그냥 수동으로 하거나, 대충 엑셀로 비슷하게 만들어 썼습니다. 정말 필요하면 직접 구현하기도 했지만, 아주 드문 일이었습니다. 하지만 이제는 필요한 걸 말만 하면 앱이 만들어집니다. 그만큼 중요해지는 것은 코딩 실력 자체보다는 내가 무엇을 원하는지 아는 능력, 그리고 결과가 맞는지 판단하는 눈이라고 생각합니다.
필요한 앱을 만들어 쓰는 시대입니다. 필요한 것을 정의하는 능력이 더 중요합니다.
ChulJoo Kim (김철주)
※ 참고문헌
- Meta, 「Threads에서 인사이트 조회하기」, Instagram 고객 센터, 2026.
- Meta, 「Threads 정보 검토 및 내보내기」, Instagram 고객 센터, 2026.
- Threads, 「Rolling out this week: Dig a bit deeper into insights」, Threads, 2025. 7.
- Threads, 「You can search for posts on your profile」, Threads, 2025. 8.
- PostEverywhere, 「Threads Metrics and KPIs: What to Track and Why」, PostEverywhere, 2026.
- Digital Takeout Day, 「How to download your Threads data」, Digital Takeout Day, 2026.
- Miles Okada, 「UpGuard 연구, 16,326개의 Supabase 데이터베이스가 읽기 가능한 테이블을 노출함을 발견」, Unite.AI, 2026. 9.
- UpGuard, 「Everything Everywhere: Systemic Data Exposure in Supabase Apps」, UpGuard, 2026. 9.
ckarch.kr
© 2026
is licensed under
CC BY-NC-SA 4.0


